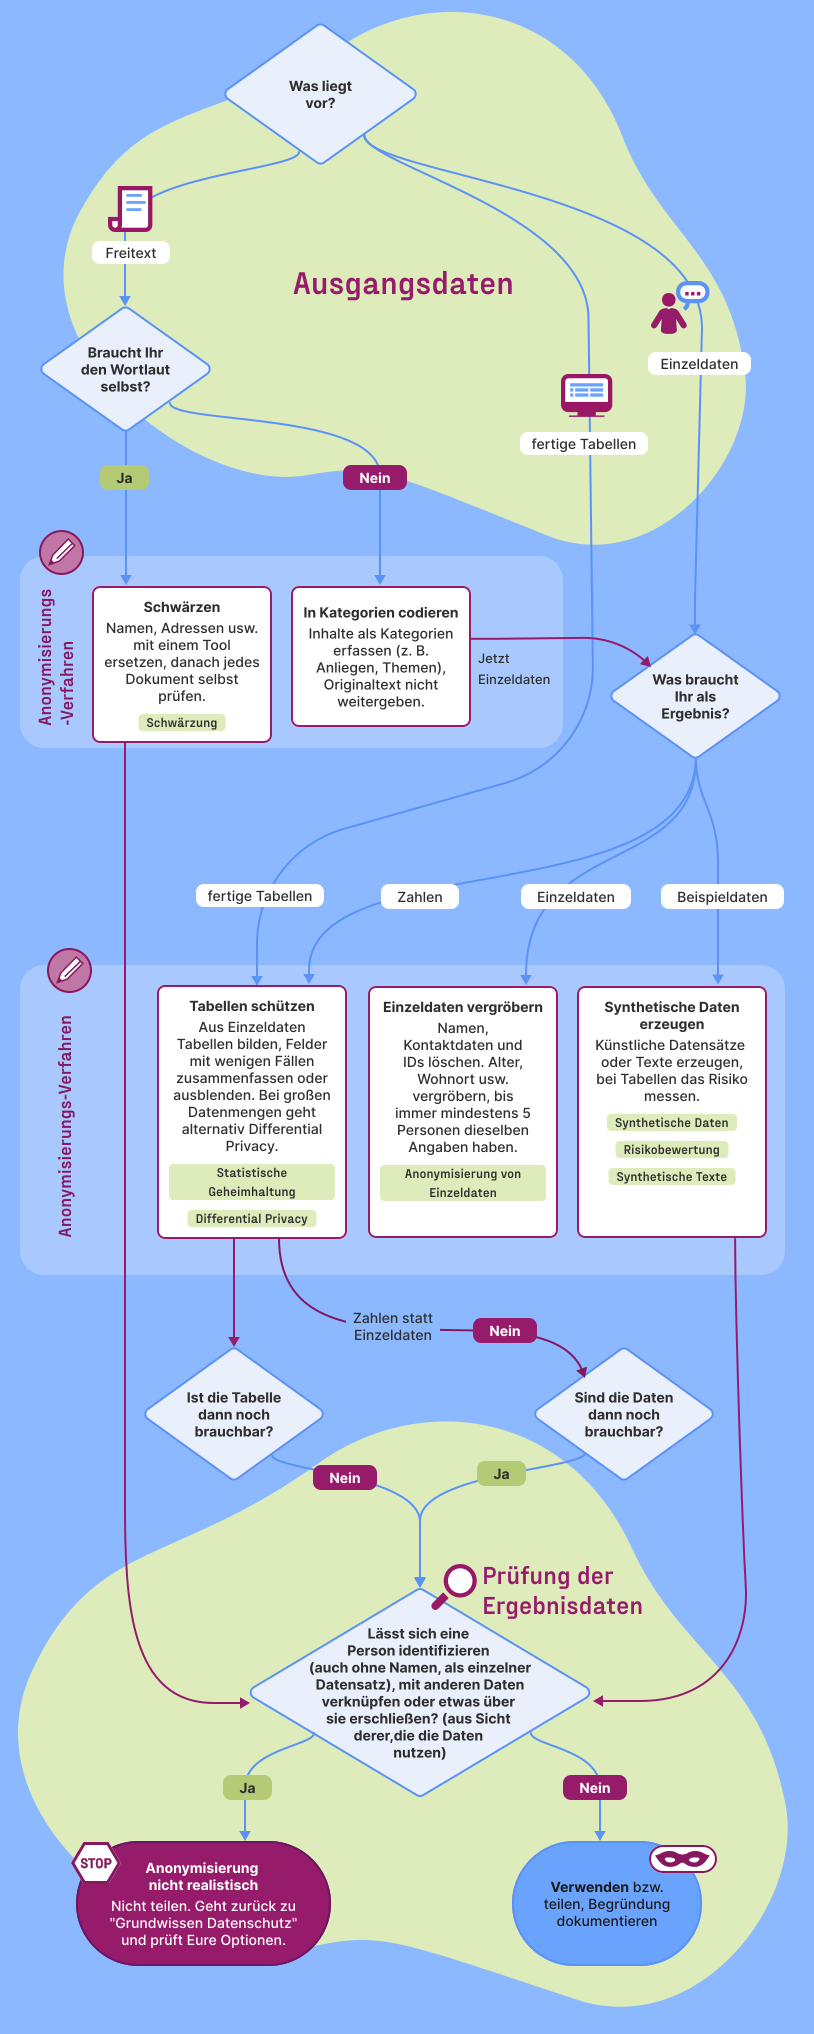
Tabellen schützen
Eine Tabelle mit dem Anteil zufriedener Mitglieder pro Altersgruppe verrät deutlich weniger als die Liste aller Antworten. Ganz sicher ist sie trotzdem nicht. Steht in einem Feld nur eine Person, ist ihre Antwort für alle sichtbar.
Felder mit wenigen Fällen werden deshalb zusammengefasst oder ausgeblendet. Hat die Abteilung Schach nur zwei Mitglieder, werden kleine Abteilungen gemeinsam als „Sonstige“ ausgewiesen. Statistikämter nennen das statistische Geheimhaltung. Als Faustregel sollten in jedem Feld mindestens 5 Personen stehen. Achtet auch auf Summen: Ein ausgeblendetes Feld lässt sich oft aus der Zeilen- oder Spaltensumme zurückrechnen.
Ob die Tabelle danach noch brauchbar ist, zeigt die Frage, für die sie gedacht war. Lässt sich die noch beantworten, passt es. Sind dagegen die meisten Felder ausgeblendet oder landet fast alles unter „Sonstige“, ist die Gruppe für diese Auswertung zu klein. Dann hilft nur, gröber zu fragen, etwa nach Altersgruppen statt nach Abteilungen, oder auf die Tabelle zu verzichten.
Statistische Geheimhaltung
Bei großen Datenmengen: Differential Privacy
Differentielle Privatsphäre (en: Differential PrivacyDifferential PrivacyDifferential Privacy ist ein Konzept des Datenschutzes, das die Freigabe von Daten oder Ergebnissen von Datenanalysen mit einer mathematischen Garantie des Datenschutzes ermöglicht. Im Mittelpunkt stehen Algorithmen zur Datenfreigabe (z. B. zur Berechnung des Mittelwerts, der Summe, der Anzahl usw. eines Datensatzes), die analytische Abfragen entgegennehmen und Ergebnisse produzieren, die auf kontrollierte, zufällige Weise verändert wurden. Übersetzt von hier: https://medium.com/dsaid-govtech/protecting-your-data-privacy-with-differential-privacy-an-introduction-abee1d7fcb63 Den Daten wird sogenanntes Rauschen zugefügt. Dahinter stecken verschiedene Verfahren, um eine Art kontrollierten Zufall bei der Beantwortung von Abfragen einzuführen. (https://cispa.de/differential-privacy) Wann/wo wird Rauschen hinzugefügt? Rauschen/Noise wird bei der Berechnung der Aggregierten Kennzahlen hinzugefügt (“Global mode”) Rauschen/Noise wird den einzelnen Datenpunkten vor der Aggregation hinzugefügt (“local mode”) Weitere Quellen: https://desfontain.es/blog/friendly-intro-to-differential-privacy.html) geht einen anderen Weg. Statt Felder zusammenzufassen, wird den Ergebnissen gezielt ein kleiner Zufallsfehler hinzugefügt, ein sogenanntes Rauschen. Das Rauschen ist so bemessen, dass das Ergebnis der Auswertung fast gleich bleibt, egal ob eine bestimmte Person mitgemacht hat oder nicht. Was eine einzelne Person geantwortet hat, lässt sich daraus kaum noch ablesen.
Beispiel Münzwurf: In einer Umfrage wird gefragt, ob jemand im Verein schon einmal Diskriminierung erlebt hat. Vor der Antwort wirft jede Person heimlich eine Münze. Bei Kopf antwortet sie ehrlich. Bei Zahl wirft sie noch einmal und antwortet bei Kopf mit „ja“ und bei Zahl mit „nein“. Ein einzelnes „ja“ kann also immer auch vom Zufall kommen. Weil bekannt ist, wie oft der Zufall entscheidet, lässt sich der Anteil der echten Ja-Antworten in der Gruppe trotzdem gut schätzen.
Differential Privacy funktioniert vor allem bei großen Datenmengen gut. Eingesetzt wird es zum Beispiel von Statistikämtern und großen Unternehmen. Bei kleineren Datenmengen hat das Anwenden des Rauschens oft zu große Effekte auf die gezogenen Schlüsse.
Differential Privacy
Einzeldaten vergröbern
Einzeldaten verraten mehr als jede Tabelle. Gebt sie deshalb nur weiter, wenn die Empfangenden wirklich eigene Auswertungen rechnen müssen. Dann werden zuerst Namen, Kontaktdaten und IDs gelöscht, also alles, was eine Person direkt benennt: Name, E-Mail-Adresse, Telefonnummer, Anschrift, Mitgliedsnummer. Namen nur durch Nummern zu ersetzen reicht nicht. Solange es eine Liste gibt, die Nummern und Namen verbindet, sind die Daten pseudonym und bleiben personenbezogen (mehr dazu im Grundwissen Datenschutz).
Wie das Beispiel oben zeigt, reicht das allein meist nicht. Die übrigen Angaben werden deshalb vergröbert. Statt des genauen Alters wird nur die Altersgruppe weitergegeben, also etwa „40 bis 49“ statt „43“. Seltene Angaben werden zusammengefasst, zum Beispiel kleine Abteilungen als „Sonstige“. Angaben, die niemand auswertet, bleiben ganz weg.
Beispiel Mitgliederumfrage: Namen und E-Mail-Adressen werden gelöscht, Ortsteil und Abteilung bleiben im Verein und das Alter wird nur in Gruppen weitergegeben. Ob das reicht, zeigt die k-Anonymität.
Wie grob es sein muss, hängt davon ab, wer die Daten bekommt. Eine Analyst*in, die zur Vertraulichkeit verpflichtet ist, braucht vielleicht mehr Detail, als bei einer Veröffentlichung als Open Data vertretbar wäre. Je sensibler die Daten und je größer der Kreis der Empfangenden, desto gröber sollten sie sein.
Der Preis ist weniger Detail. Klärt vorher mit den Empfangenden, was sie brauchen, und prüft danach, ob die Daten noch brauchbar sind. Wenn nicht, gebt besser Zahlen statt Einzeldaten weiter (Tabellen schützen).
Anonymisierung von Einzeldaten
Wie grob ist grob genug? (k-Anonymität)
k-Anonymität hilft bei der Frage, ob die Vergröberung ausreicht. Die Idee ist einfach. Jede Kombination der kritischen Merkmale soll im Datensatz mindestens k-mal vorkommen. Bei k = 3 gibt es also zu jeder Kombination mindestens drei Personen, und es lässt sich nicht mehr sagen, wer von ihnen welche Antwort gegeben hat. Wir zeigen k = 3, damit die Tabelle kurz bleibt. Als Faustregel gilt k = 5.
Kritisch sind vor allem Merkmale, die andere über eine Person wissen können, etwa Alter, Wohnort, Geschlecht oder eine Funktion in der Organisation.
Vorher
| Alter |
Ortsteil |
Zufrieden mit dem Vorstand |
| 34 |
Nord
|
ja
|
| 37 |
Nord
|
nein
|
| 31 |
Nord
|
ja
|
| 62 |
Süd
|
nein
|
| 68 |
Süd
|
ja
|
| 65 |
Süd
|
nein
|
Nachher (k = 3)
| Alter |
Ortsteil |
Zufrieden mit dem Vorstand |
|
30 bis 39
|
Nord
|
ja
|
|
30 bis 39
|
Nord
|
nein
|
|
30 bis 39
|
Nord
|
ja
|
|
60 bis 69
|
Süd
|
nein
|
|
60 bis 69
|
Süd
|
ja
|
|
60 bis 69
|
Süd
|
nein
|
Wer weiß, dass die 34-jährige Nachbarin aus Nord mitgemacht hat, findet ihre Antwort in der ersten Tabelle sofort. In der zweiten Tabelle kommen drei Personen infrage.
Erreicht wird k-Anonymität durch Vergröbern, Zusammenfassen und notfalls durch das Weglassen einzelner Zeilen. Wie groß k sein sollte, hängt davon ab, wie sensibel die Daten sind und wer sie bekommt.
Eine Grenze hat k-Anonymität allerdings. Hätten alle drei Personen aus der Gruppe „60 bis 69, Süd“ mit „nein“ geantwortet, wüsste man die Antwort jeder einzelnen Person trotzdem. Deshalb sollten sich sensible Antworten innerhalb jeder Gruppe unterscheiden (l-Diversität).
Anonymisierung von Einzeldaten Risikobewertung
Synthetische Daten erzeugen
Statt echte Daten weiterzugeben, lässt sich ein künstlicher Datensatz erzeugen, der dieselben Muster zeigt: eine ähnliche Altersverteilung, ähnliche Zusammenhänge zwischen den Antworten, aber keine echten Personen. Das eignet sich zum Ausprobieren, für Schulungen oder damit Externe eine Auswertung vorbereiten, bevor sie mit den echten Daten läuft.
Künstlich heißt aber nicht automatisch anonym. Hat das Programm seltene Fälle zu genau gelernt, tauchen sie im künstlichen Datensatz wieder auf. Prüft das Ergebnis deshalb mit einem Tool zur Risikobewertung.
Synthetische Daten Risikobewertung
Freitext und Dokumente
Bei offenen Antworten und Dokumenten ist AnonymisierungAnonymisierungPersonenbezogene Daten, die so anonymisiert wurden, dass die Person nicht mehr identifizierbar ist, gelten nicht als personenbezogene Daten. Damit Daten wirklich anonymisiert sind, muss die Anonymisierung unumkehrbar sein. Übersetzt von: https://commission.europa.eu/law/law-topic/data-protection/data-protection-explained_en deutlich schwerer. In Freitexten nennen Menschen Namen, Orte und Erlebnisse, oft ohne darüber nachzudenken. Ein Satz wie „Seit dem Streit beim Sommerfest gehe ich nicht mehr zum Training“ reicht in einer kleinen Organisation vielleicht schon aus. Auch der Schreibstil kann verraten, wer etwas geschrieben hat.
Kategorien bilden ist deshalb oft der sicherste Weg. Dabei wird jede Antwort einem oder mehreren Themen zugeordnet, etwa „Trainingszeiten“, „Kommunikation des Vorstands“ oder „Konflikt im Team“. Weitergegeben wird nur die Zuordnung, nicht der Text. Legt die Kategorien vorher fest und haltet sie so grob, dass keine nur auf eine Person passt. Das Ergebnis sind Einzeldaten oder Zahlen, die Ihr schützt wie unter Einzeldaten vergröbern und Tabellen schützen beschrieben.
Braucht Ihr trotzdem Texte, etwa für Schulungen oder um eine Auswertung zu testen, könnt Ihr aus den Kategorien künstliche Beispieltexte erzeugen lassen. Gebt dem Programm dafür nur die Kategorien, nie die echten Texte. Sonst tauchen echte Formulierungen im Ergebnis wieder auf.
Schwärzen heißt, Namen, Adressen, Telefonnummern usw. im Text zu ersetzen, am besten durch Platzhalter wie [Person 1], damit der Text lesbar bleibt. Programme, die Namen automatisch erkennen, nehmen dabei viel Arbeit ab, übersehen aber indirekte Hinweise wie den Streit beim Sommerfest. Namen und Orte, die beim Training dieser Programme selten vorkamen, erkennen sie oft schlechter. Das betrifft besonders Menschen mit nicht-westlichen Namen. Lest jedes Dokument nach dem Schwärzen deshalb selbst noch einmal durch.
Versteckte Angaben in Dateien entfernen. Office-Dokumente und PDFs speichern oft, wer sie erstellt oder bearbeitet hat. Fotos vom Smartphone enthalten häufig Ort und Uhrzeit der Aufnahme. Diese sogenannten MetadatenMetadatenMetadaten sind Daten, die Informationen über andere Daten bereitstellen. Sie beschreiben Merkmale wie das Erstellungsdatum, den Autor, das Format und die Dateigröße und sind entscheidend für die Verwaltung, Suche und Nutzung von Informationen. Metadaten helfen, die Organisation von und den Zugriff auf Daten zu verbessern und deren Kontext zu verstehen. lassen sich in den meisten Programmen über die Datei-Eigenschaften löschen.
Fotos, Audio und Video deckt diese Anleitung nicht ab.
Schwärzung Synthetische Texte
 Zum Schluss: Ist das Ergebnis anonym?
Egal welches Verfahren Ihr nutzt, am Ende steht dieselbe Prüfung. Anonym sind die Daten erst, wenn sich keine Person darin mit vertretbarem Aufwand wiedererkennen lässt (s. Warum echte Anonymisierung schwer ist). Dafür helfen drei Fragen: Lässt sich eine Person identifizieren, auch ohne Namen und als einzelner Datensatz? Lassen sich die Daten mit anderen Daten verknüpfen? Lässt sich etwas über eine Person erschließen? Beantwortet diese Fragen aus Sicht derer, die die Daten bekommen, also mit ihrem Zusatzwissen.
Ist die Antwort überall nein, könnt Ihr die Daten verwenden oder teilen. Haltet fest, warum Ihr sie für anonym haltet. Ist die Antwort ja und lässt sich das nicht weiter verbessern, ist Anonymisierung hier nicht realistisch. Dann teilt die Daten nicht und nutzt sie nur so weit, wie es das Grundwissen Datenschutz erlaubt.
Risikobewertung



 Verfahren im Detail

