← Übersicht Werkstattbox Anonymisierung

Praxisanleitung Anonymisierung

Ihr dürft und möchtet Eure Daten anonymisieren? Dann findet Ihr hier einen Überblick über die wichtigsten Anonymisierungsverfahren. Prüft mit dem Flowchart, welche davon zu Euren Daten passen und lernt Tools kennen, die Ihr dafür einsetzen könnt.

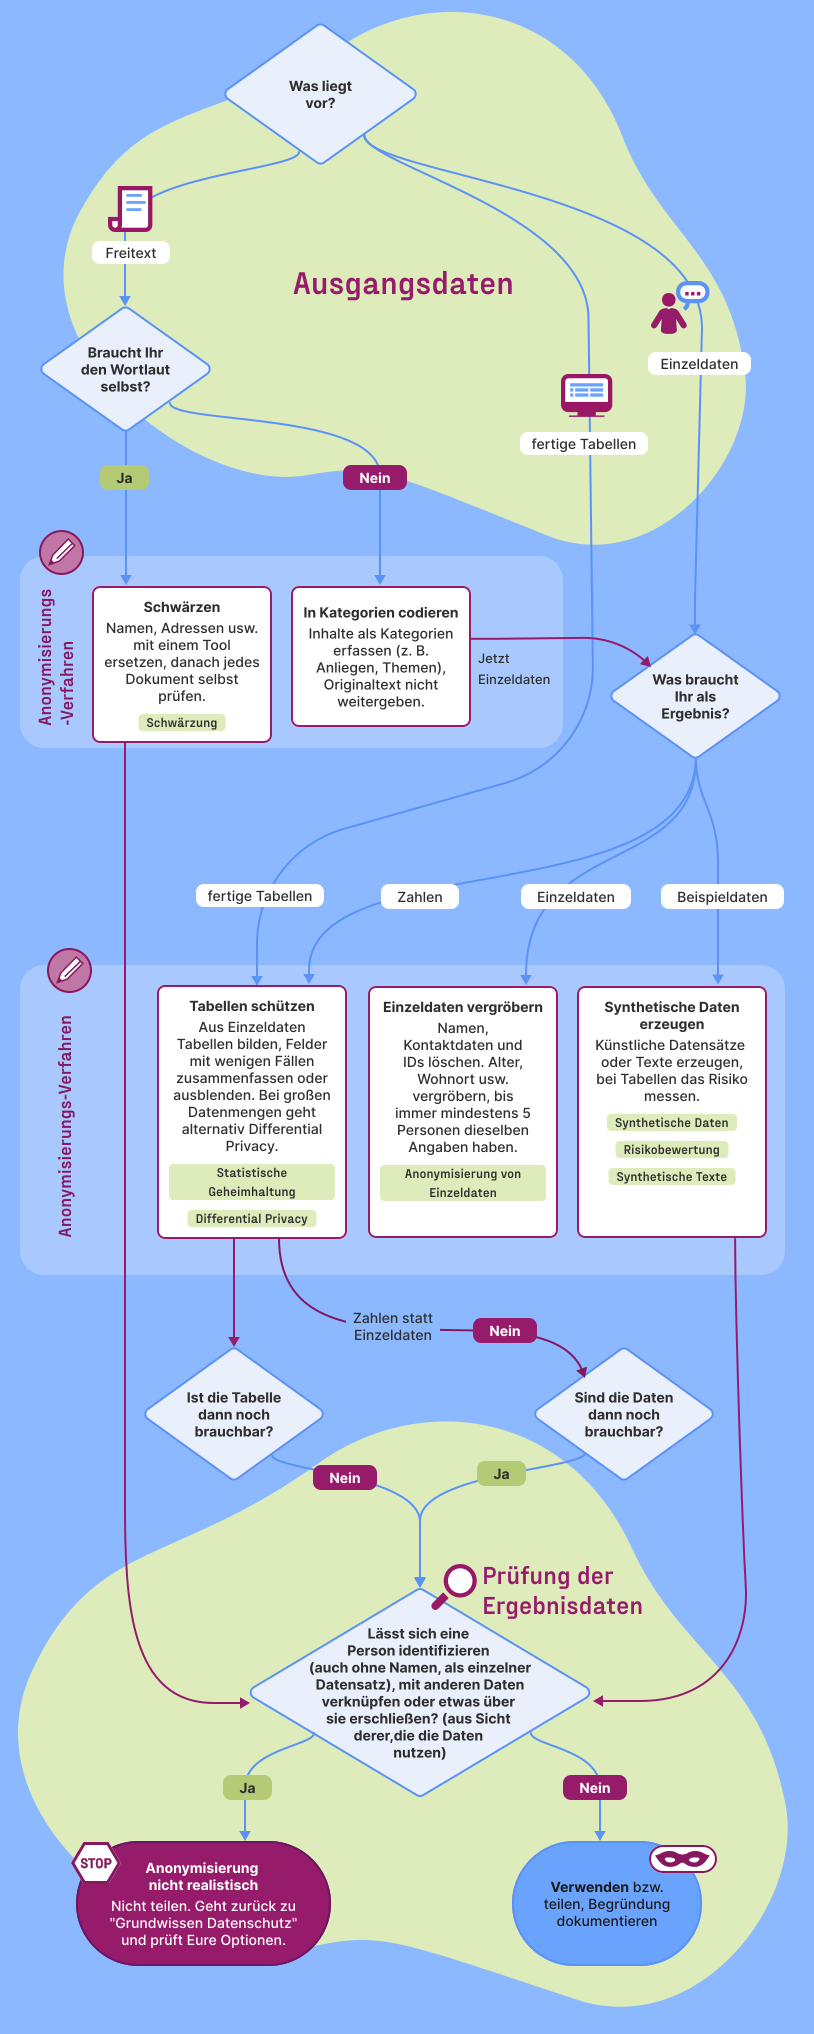
Das Flowchart zeigt, welche Anonymisierungsverfahren zu Euren Daten passen. Die Kästen und grünen Markierungen führen zu den passenden Abschnitten und Tools auf dieser Seite.

So nutzt Ihr das Flowchart

Beginnt oben und beantwortet jede Frage für Euren konkreten Datensatz.

  • Rauten sind Fragen. Folgt dem Pfeil, der auf Eure Daten zutrifft.
  • Rechtecke sind Arbeitsschritte. Die grünen Tags darin nennen die passenden Tools.
  • Ovale sind Endpunkte. Ein lila Oval mit Stopp-Schild heißt: Diese Daten dürft Ihr nicht weiterverarbeiten.

Zum Anklicken: Arbeitsschritte führen zur Erklärung weiter unten, grüne Tags direkt zur Tabelle mit den Tools.

Wo findet Ihr die Toolempfehlungen?

Grüne Tags verweisen auf Tools, die Ihr weiter unten auf dieser Seite in Tabellen findet!

Zu den Tools
Übergangswelle

Über Anonymisierungsverfahren

Anonymisieren ist selbst eine Datenverarbeitung

Solange die Daten noch personenbezogen sind, gilt für jeden Schritt die DSGVO, auch für das Anonymisieren selbst. Ihr braucht dafür einen Zweck und eine Rechtsgrundlage, bei sensiblen Daten wie Gesundheit oder Religion zusätzlich eine nach Art. 9 Abs. 2 DSGVO. Außerdem müsst Ihr die Betroffenen informieren, etwa in Eurer Datenschutzerklärung.

Meist ist das kein großes Hindernis. Anonymisieren gilt in der Regel als vereinbar mit dem Zweck, für den Ihr die Daten erhoben habt (Art. 6 Abs. 4 DSGVO), wenn das Ergebnis wirklich anonym ist. Legt trotzdem vorher fest, wofür die anonymen Daten gebraucht werden, zum Beispiel für den Jahresbericht oder eine externe Auswertung. Davon hängt auch ab, wie grob sie sein müssen. Die rechtlichen Grundlagen und ob Ihr die Daten für Euren Zweck überhaupt nutzen dürft, klärt das Grundwissen Datenschutz.

Warum echte Anonymisierung schwer ist

Einen Datensatz zu anonymisieren heißt, dass sich keine Person darin mit vertretbarem Aufwand wiedererkennen lässt (vgl. Erwägungsgrund 26 DSGVO). Aber Achtung: Namen und E-Mail-Adressen zu löschen reicht dafür meist nicht aus.

Praxisbeispiel: Ein Sportverein mit 80 Mitgliedern fragt in einer Umfrage nach der Zufriedenheit mit dem Vorstand. Namen werden nicht erhoben. Gefragt wird aber nach Alter, Ortsteil, Abteilung und ob jemand ein Ehrenamt im Verein hat. Hinter der Antwort „43 Jahre, Ortsteil Nord, Abteilung Tischtennis, Ehrenamt ja“ erkennen viele im Verein sofort die Kassenwartin. Ihre Kommentare zum Vorstand sind damit nicht mehr anonym.

Im Beispiel verrät keines dieser Merkmale die Person für sich allein. Erst die Kombination mehrerer Merkmale macht sie eindeutig. Seltene Angaben können aber auch allein reichen, etwa wenn nur ein Mitglied über 90 ist. Je kleiner der Datensatz und je seltener eine Angabe, desto schneller passiert das.

Dazu kommt das Zusatzwissen der Menschen, die die Daten bekommen. Eine externe Analyst*in, die niemanden im Verein kennt, kann mit der Antwort oben wenig anfangen. Ein Vereinsmitglied, das bei der Auswertung hilft, erkennt die Kassenwartin dagegen sofort. Ob Daten anonym sind, hängt also auch davon ab, wer sie bekommt.

Welche Daten liegen vor?

Das Flowchart unterscheidet drei Arten von Daten. Für jede gibt es andere Verfahren, deshalb lohnt es sich, genau hinzuschauen.

  • Einzeldaten haben eine Zeile pro Person, zum Beispiel eine Mitgliederliste, eine Teilnahmeliste oder die Antworten einer Umfrage als Excel-Export. Auch ohne Namen gehört jede Zeile zu genau einem Menschen.
  • Tabellen (auch: aggregierte Daten) enthalten bereits ausgezählte Ergebnisse, zum Beispiel „12 Teilnehmende zwischen 30 und 39 Jahren“. Ein Feld steht hier für eine Gruppe, nicht für eine Person. Kleine Gruppen können aber trotzdem auf Einzelne verweisen.
  • Freitext ist alles, was Menschen in eigenen Worten geschrieben haben: offene Antworten, Beratungsnotizen, Protokolle, E-Mails und andere Dokumente.

Oft kommt mehreres zusammen. Eine Umfrage enthält meist Einzeldaten und Freitext, nämlich die offenen Antworten. Behandelt dann jeden Teil mit seinem eigenen Verfahren. Übersehen werden dabei leicht Spalten wie „Bemerkungen“, in denen oft Namen stehen.

Auch die Form des Ergebnisses entscheidet mit. Je mehr Detail Ihr weitergebt, desto größer das Risiko. Zahlen und Tabellen verraten am wenigsten, Einzeldaten deutlich mehr. Synthetische Beispieldaten enthalten keine echten Personen, eignen sich aber nur zum Ausprobieren und nicht für echte Ergebnisse.

Verfahren im Detail

Welcher Schritt zu Euren Daten passt, zeigt das Flowchart oben. Hier lest Ihr, was hinter den Schritten steckt, woran Ihr erkennt, ob sie reichen, und welche Fehler häufig passieren.

Tabellen schützen

Eine Tabelle mit dem Anteil zufriedener Mitglieder pro Altersgruppe verrät deutlich weniger als die Liste aller Antworten. Ganz sicher ist sie trotzdem nicht. Steht in einem Feld nur eine Person, ist ihre Antwort für alle sichtbar.

Felder mit wenigen Fällen werden deshalb zusammengefasst oder ausgeblendet. Hat die Abteilung Schach nur zwei Mitglieder, werden kleine Abteilungen gemeinsam als „Sonstige“ ausgewiesen. Statistikämter nennen das statistische Geheimhaltung. Als Faustregel sollten in jedem Feld mindestens 5 Personen stehen. Achtet auch auf Summen: Ein ausgeblendetes Feld lässt sich oft aus der Zeilen- oder Spaltensumme zurückrechnen.

Ob die Tabelle danach noch brauchbar ist, zeigt die Frage, für die sie gedacht war. Lässt sich die noch beantworten, passt es. Sind dagegen die meisten Felder ausgeblendet oder landet fast alles unter „Sonstige“, ist die Gruppe für diese Auswertung zu klein. Dann hilft nur, gröber zu fragen, etwa nach Altersgruppen statt nach Abteilungen, oder auf die Tabelle zu verzichten.

Bei großen Datenmengen: Differential Privacy

Differentielle Privatsphäre (en: Differential PrivacyDifferential PrivacyDifferential Privacy ist ein Konzept des Datenschutzes, das die Freigabe von Daten oder Ergebnissen von Datenanalysen mit einer mathematischen Garantie des Datenschutzes ermöglicht. Im Mittelpunkt stehen Algorithmen zur Datenfreigabe (z. B. zur Berechnung des Mittelwerts, der Summe, der Anzahl usw. eines Datensatzes), die analytische Abfragen entgegennehmen und Ergebnisse produzieren, die auf kontrollierte, zufällige Weise verändert wurden.  Übersetzt von hier: https://medium.com/dsaid-govtech/protecting-your-data-privacy-with-differential-privacy-an-introduction-abee1d7fcb63  Den Daten wird sogenanntes Rauschen zugefügt. Dahinter stecken verschiedene Verfahren, um eine Art kontrollierten Zufall bei der Beantwortung von Abfragen einzuführen. (https://cispa.de/differential-privacy)  Wann/wo wird Rauschen hinzugefügt? Rauschen/Noise wird bei der Berechnung der Aggregierten Kennzahlen hinzugefügt (“Global mode”) Rauschen/Noise wird den einzelnen Datenpunkten vor der Aggregation hinzugefügt (“local mode”) Weitere Quellen: https://desfontain.es/blog/friendly-intro-to-differential-privacy.html) geht einen anderen Weg. Statt Felder zusammenzufassen, wird den Ergebnissen gezielt ein kleiner Zufallsfehler hinzugefügt, ein sogenanntes Rauschen. Das Rauschen ist so bemessen, dass das Ergebnis der Auswertung fast gleich bleibt, egal ob eine bestimmte Person mitgemacht hat oder nicht. Was eine einzelne Person geantwortet hat, lässt sich daraus kaum noch ablesen.

Beispiel Münzwurf: In einer Umfrage wird gefragt, ob jemand im Verein schon einmal Diskriminierung erlebt hat. Vor der Antwort wirft jede Person heimlich eine Münze. Bei Kopf antwortet sie ehrlich. Bei Zahl wirft sie noch einmal und antwortet bei Kopf mit „ja“ und bei Zahl mit „nein“. Ein einzelnes „ja“ kann also immer auch vom Zufall kommen. Weil bekannt ist, wie oft der Zufall entscheidet, lässt sich der Anteil der echten Ja-Antworten in der Gruppe trotzdem gut schätzen.

Differential Privacy funktioniert vor allem bei großen Datenmengen gut. Eingesetzt wird es zum Beispiel von Statistikämtern und großen Unternehmen. Bei kleineren Datenmengen hat das Anwenden des Rauschens oft zu große Effekte auf die gezogenen Schlüsse.

Einzeldaten vergröbern

Einzeldaten verraten mehr als jede Tabelle. Gebt sie deshalb nur weiter, wenn die Empfangenden wirklich eigene Auswertungen rechnen müssen. Dann werden zuerst Namen, Kontaktdaten und IDs gelöscht, also alles, was eine Person direkt benennt: Name, E-Mail-Adresse, Telefonnummer, Anschrift, Mitgliedsnummer. Namen nur durch Nummern zu ersetzen reicht nicht. Solange es eine Liste gibt, die Nummern und Namen verbindet, sind die Daten pseudonym und bleiben personenbezogen (mehr dazu im Grundwissen Datenschutz).

Wie das Beispiel oben zeigt, reicht das allein meist nicht. Die übrigen Angaben werden deshalb vergröbert. Statt des genauen Alters wird nur die Altersgruppe weitergegeben, also etwa „40 bis 49“ statt „43“. Seltene Angaben werden zusammengefasst, zum Beispiel kleine Abteilungen als „Sonstige“. Angaben, die niemand auswertet, bleiben ganz weg.

Beispiel Mitgliederumfrage: Namen und E-Mail-Adressen werden gelöscht, Ortsteil und Abteilung bleiben im Verein und das Alter wird nur in Gruppen weitergegeben. Ob das reicht, zeigt die k-Anonymität.

Wie grob es sein muss, hängt davon ab, wer die Daten bekommt. Eine Analyst*in, die zur Vertraulichkeit verpflichtet ist, braucht vielleicht mehr Detail, als bei einer Veröffentlichung als Open Data vertretbar wäre. Je sensibler die Daten und je größer der Kreis der Empfangenden, desto gröber sollten sie sein.

Der Preis ist weniger Detail. Klärt vorher mit den Empfangenden, was sie brauchen, und prüft danach, ob die Daten noch brauchbar sind. Wenn nicht, gebt besser Zahlen statt Einzeldaten weiter (Tabellen schützen).

Wie grob ist grob genug? (k-Anonymität)

k-Anonymität hilft bei der Frage, ob die Vergröberung ausreicht. Die Idee ist einfach. Jede Kombination der kritischen Merkmale soll im Datensatz mindestens k-mal vorkommen. Bei k = 3 gibt es also zu jeder Kombination mindestens drei Personen, und es lässt sich nicht mehr sagen, wer von ihnen welche Antwort gegeben hat. Wir zeigen k = 3, damit die Tabelle kurz bleibt. Als Faustregel gilt k = 5.

Kritisch sind vor allem Merkmale, die andere über eine Person wissen können, etwa Alter, Wohnort, Geschlecht oder eine Funktion in der Organisation.

Vorher

Alter Ortsteil Zufrieden mit dem Vorstand
34

Nord

ja

37

Nord

nein

31

Nord

ja

62

Süd

nein

68

Süd

ja

65

Süd

nein

Nachher (k = 3)

Alter Ortsteil Zufrieden mit dem Vorstand

30 bis 39

Nord

ja

30 bis 39

Nord

nein

30 bis 39

Nord

ja

60 bis 69

Süd

nein

60 bis 69

Süd

ja

60 bis 69

Süd

nein

Wer weiß, dass die 34-jährige Nachbarin aus Nord mitgemacht hat, findet ihre Antwort in der ersten Tabelle sofort. In der zweiten Tabelle kommen drei Personen infrage.

Erreicht wird k-Anonymität durch Vergröbern, Zusammenfassen und notfalls durch das Weglassen einzelner Zeilen. Wie groß k sein sollte, hängt davon ab, wie sensibel die Daten sind und wer sie bekommt.

Eine Grenze hat k-Anonymität allerdings. Hätten alle drei Personen aus der Gruppe „60 bis 69, Süd“ mit „nein“ geantwortet, wüsste man die Antwort jeder einzelnen Person trotzdem. Deshalb sollten sich sensible Antworten innerhalb jeder Gruppe unterscheiden (l-Diversität).

Synthetische Daten erzeugen

Statt echte Daten weiterzugeben, lässt sich ein künstlicher Datensatz erzeugen, der dieselben Muster zeigt: eine ähnliche Altersverteilung, ähnliche Zusammenhänge zwischen den Antworten, aber keine echten Personen. Das eignet sich zum Ausprobieren, für Schulungen oder damit Externe eine Auswertung vorbereiten, bevor sie mit den echten Daten läuft.

Künstlich heißt aber nicht automatisch anonym. Hat das Programm seltene Fälle zu genau gelernt, tauchen sie im künstlichen Datensatz wieder auf. Prüft das Ergebnis deshalb mit einem Tool zur Risikobewertung.

Freitext und Dokumente

Bei offenen Antworten und Dokumenten ist AnonymisierungAnonymisierungPersonenbezogene Daten, die so anonymisiert wurden, dass die Person nicht mehr identifizierbar ist, gelten nicht als personenbezogene Daten. Damit Daten wirklich anonymisiert sind, muss die Anonymisierung unumkehrbar sein. Übersetzt von: https://commission.europa.eu/law/law-topic/data-protection/data-protection-explained_en deutlich schwerer. In Freitexten nennen Menschen Namen, Orte und Erlebnisse, oft ohne darüber nachzudenken. Ein Satz wie „Seit dem Streit beim Sommerfest gehe ich nicht mehr zum Training“ reicht in einer kleinen Organisation vielleicht schon aus. Auch der Schreibstil kann verraten, wer etwas geschrieben hat.

Kategorien bilden ist deshalb oft der sicherste Weg. Dabei wird jede Antwort einem oder mehreren Themen zugeordnet, etwa „Trainingszeiten“, „Kommunikation des Vorstands“ oder „Konflikt im Team“. Weitergegeben wird nur die Zuordnung, nicht der Text. Legt die Kategorien vorher fest und haltet sie so grob, dass keine nur auf eine Person passt. Das Ergebnis sind Einzeldaten oder Zahlen, die Ihr schützt wie unter Einzeldaten vergröbern und Tabellen schützen beschrieben.

Braucht Ihr trotzdem Texte, etwa für Schulungen oder um eine Auswertung zu testen, könnt Ihr aus den Kategorien künstliche Beispieltexte erzeugen lassen. Gebt dem Programm dafür nur die Kategorien, nie die echten Texte. Sonst tauchen echte Formulierungen im Ergebnis wieder auf.

Schwärzen heißt, Namen, Adressen, Telefonnummern usw. im Text zu ersetzen, am besten durch Platzhalter wie [Person 1], damit der Text lesbar bleibt. Programme, die Namen automatisch erkennen, nehmen dabei viel Arbeit ab, übersehen aber indirekte Hinweise wie den Streit beim Sommerfest. Namen und Orte, die beim Training dieser Programme selten vorkamen, erkennen sie oft schlechter. Das betrifft besonders Menschen mit nicht-westlichen Namen. Lest jedes Dokument nach dem Schwärzen deshalb selbst noch einmal durch.

Versteckte Angaben in Dateien entfernen. Office-Dokumente und PDFs speichern oft, wer sie erstellt oder bearbeitet hat. Fotos vom Smartphone enthalten häufig Ort und Uhrzeit der Aufnahme. Diese sogenannten MetadatenMetadatenMetadaten sind Daten, die Informationen über andere Daten bereitstellen. Sie beschreiben Merkmale wie das Erstellungsdatum, den Autor, das Format und die Dateigröße und sind entscheidend für die Verwaltung, Suche und Nutzung von Informationen. Metadaten helfen, die Organisation von und den Zugriff auf Daten zu verbessern und deren Kontext zu verstehen. lassen sich in den meisten Programmen über die Datei-Eigenschaften löschen.

Fotos, Audio und Video deckt diese Anleitung nicht ab.

Zum Schluss: Ist das Ergebnis anonym?

Egal welches Verfahren Ihr nutzt, am Ende steht dieselbe Prüfung. Anonym sind die Daten erst, wenn sich keine Person darin mit vertretbarem Aufwand wiedererkennen lässt (s. Warum echte Anonymisierung schwer ist). Dafür helfen drei Fragen: Lässt sich eine Person identifizieren, auch ohne Namen und als einzelner Datensatz? Lassen sich die Daten mit anderen Daten verknüpfen? Lässt sich etwas über eine Person erschließen? Beantwortet diese Fragen aus Sicht derer, die die Daten bekommen, also mit ihrem Zusatzwissen.

Ist die Antwort überall nein, könnt Ihr die Daten verwenden oder teilen. Haltet fest, warum Ihr sie für anonym haltet. Ist die Antwort ja und lässt sich das nicht weiter verbessern, ist Anonymisierung hier nicht realistisch. Dann teilt die Daten nicht und nutzt sie nur so weit, wie es das Grundwissen Datenschutz erlaubt.

Weiterführend

Anonymisierung schützt die Personen, die im Datensatz stehen. Unter dem Stichwort Prädiktive Privatheit (en: Predictive Privacy) wird diskutiert, warum das nicht immer reicht. Aus anonymen Daten vieler Menschen lassen sich Muster lernen, mit denen Vorhersagen über andere möglich werden, zum Beispiel über ihre Gesundheit oder ihr Kaufverhalten. Betroffen sind dann auch Menschen, die selbst nie Daten geteilt haben. Das Thema Predictive Privacy geht über die DSGVO hinaus und zeigt auf, dass DatenschutzDatenschutzDatenschutz beschreibt Maßnahmen zum Schutz personenbezogener Daten vor Missbrauch, unbefugtem Zugriff und Verlust. Er umfasst Gesetze, Richtlinien und Techniken, die Organisationen verpflichten, personenbezogene Daten sicher zu verwalten. Datenschutz ist entscheidend, um das Vertrauen der Öffentlichkeit zu wahren und die Rechte Einzelner zu schützen. sehr umfassend gedacht werden muss, um Personen in ihrer Privatsphäre zu schützen.

Für Verfahren wie Vergröbern oder k-Anonymität gibt es bisher kaum Tools, die ohne Installation und Vorkenntnisse auskommen. Das Civic Data Lab entwickelt deshalb ein Tool, das tabellarische Daten (Excel, CSV usw.) direkt im Browser anonymisiert. Die Daten bleiben dabei auf Eurem Rechner. Externe Expert*innen können die Einstellungen vorbereiten, ohne die personenbezogenen Daten selbst zu sehen.

Habt Ihr Interesse an einem solchen Tool? Dann beschreibt uns gern Eure Bedarfe, etwa welche Daten Ihr weitergeben wollt und an wen. Eure Rückmeldungen fließen in die Entwicklung ein. Schreibt uns an mail@civic-data.de.

Der Europäische Datenschutzausschuss (EDSA) hat 2026 Leitlinien zur Anonymisierung veröffentlicht. Sie beschreiben, wann Daten nach der DSGVO als anonym gelten, und gehen ausführlicher auf die drei Prüffragen aus Zum Schluss: Ist das Ergebnis anonym? ein: Guidelines 02/2026 on Anonymisation (englisch).

Übergangswelle

Tools zur Anonymisierung

Statistische Geheimhaltung

Aus Einzeldaten Tabellen bilden, Felder mit wenigen Fällen zusammenfassen oder ausblenden.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
ACRO Python-Paket (auch R) Prüft Tabellen und Regressionen und erklärt, warum es etwas markiert. Hilft der prüfenden Person, ersetzt sie aber nicht. Auch für R eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. Programmieren (Python/R) kostenlos, Open Source
SACRO Viewer Programm Gehört zu ACRO. Zeigt jedes Ergebnis mit seinen Markierungen und hält fest, ob es freigegeben oder abgelehnt wurde auf Eurem Rechner etwas Einarbeitung kostenlos, Open Source

Ohne Tool: Tabellen selbst prüfen

Für einzelne Tabellen, etwa im Jahresbericht oder für einen Förderer, reichen oft Excel oder LibreOffice. Die Tools oben lohnen sich, wenn Ihr viele Tabellen oder regelmäßig dieselben Berichte erstellt.

  1. Pivot-Tabelle bilden (Excel: Einfügen → PivotTable; LibreOffice: Daten → Pivot-Tabelle).
  2. Felder mit weniger als 5 Personen markieren.
  3. Kategorien zusammenfassen (z. B. Altersgruppen „45–64“ und „65+“ zu „45+“) oder „unter 5“ statt der Zahl schreiben.
  4. Gesamtsummen prüfen. Ist in einer Zeile oder Spalte nur ein einziges Feld ausgeblendet, lässt es sich über die Summe zurückrechnen. Dann ein zweites Feld ausblenden oder die Summe weglassen.
  5. Auch eine 0 kann etwas verraten (z. B. „niemand über 65 hat die Beratung abgeschlossen“).
  6. Zum Schluss prüfen, ob das Ergebnis anonym ist.

Eine Fallzahl von 5 ist eine verbreitete Faustregel und keine gesetzliche Grenze. Bei sensiblen Daten oder in kleinen Orten setzt die Grenze höher an.

Differential Privacy

Die Alternative bei großen Datenmengen: Ein Programm rechnet Statistiken aus Einzeldaten und verändert sie gezielt um kleine Zufallswerte (Rauschen). So lässt sich mathematisch belegen, wie gut die einzelnen Personen geschützt sind.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
DP Wizard Programm mit Browser-Oberfläche Von OpenDP. Führt per Klick durch eine Auswertung mit Differential Privacy und schreibt den passenden Code. Wird über die Kommandozeile gestartet und dann im Browser bedient. Einfache Zählungen gibt es nicht direkt, und die Datei wird schon beim Hochladen ganz eingelesen auf Eurem Rechner etwas Einarbeitung kostenlos, Open Source
OpenDP Python-Paket Bausteine für Differential Privacy, nutzbar mit Python oder Rust eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. Programmieren (Python) kostenlos, Open Source

Anonymisierung von Einzeldaten

Namen, Kontaktdaten und IDs löschen. Alter, Wohnort usw. vergröbern, bis immer mindestens 5 Personen dieselben Angaben haben.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
Sanitize Data Webseite Erster Schritt: ersetzt direkte Merkmale wie Namen, E-Mails, IDs und Adressen durch gleichbleibende Ersatzwerte. Liest CSV und Excel (nur das erste Blatt). Alter, PLZ usw. ändert es nicht, die müsst Ihr danach vergröbern im Browser keine kostenlos
Amnesia Programm Leicht zu bedienen, baut teilweise auf ARX auf. Gibt es auch als Online-Version auf Eurem Rechner keine kostenlos, Open Source
ARX Programm Kommt aus der Forschung und kann sehr viel, z. B. k-Anonymität, l-Diversität und Risikoanalyse auf Eurem Rechner etwas Einarbeitung kostenlos, Open Source
sdcMicro R-Paket mit grafischer Benutzeroberfläche Standard in der amtlichen Statistik und in Forschungsdatenzentren. Die Benutzeroberfläche heißt sdcApp eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. etwas Einarbeitung (R) kostenlos, Open Source

Risikobewertung

Bei Tabellen das Risiko messen. Diese Tools ändern an den Daten nichts. Sie messen, wie leicht sich Personen herausgreifen oder verknüpfen und Merkmale erschließen lassen. Für vergröberte Einzeldaten messen ARX und sdcMicro das Risiko gleich mit. Beide haben eine grafische Benutzeroberfläche.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
Anonymeter Python-Paket Vergleicht synthetische DatenSynthetische DatenSynthetische Daten sind künstliche Daten, die aus Originaldaten und einem Modell erzeugt werden, das so trainiert ist, dass es die Merkmale und die Struktur der Originaldaten reproduziert. Das bedeutet, dass synthetische Daten und Originaldaten sehr ähnliche Ergebnisse liefern sollten, wenn sie der gleichen statistischen Analyse unterzogen werden. Übersetzt von: https://www.edps.europa.eu/press-publications/publications/techsonar/synthetic-data_de mit den Originalen und misst dabei die drei EDSA-Kriterien (Herausgreifen, Verknüpfen, Erschließen) eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. Programmieren (Python) kostenlos, Open Source

Synthetische Daten

Künstliche Datensätze erzeugen, die den echten ähneln. Sie sind nicht automatisch anonym. Prüft sie deshalb danach mit einem Tool zur Risikobewertung.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
synthpop R-Paket In der Sozialforschung weit verbreitet eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. Programmieren (R) kostenlos, Open Source
MOSTLY AI Synthetic Data SDK Python-Paket Erzeugt mit einem KI-Modell künstliche Tabellen. Ein kommerzieller Anbieter hat es 2025 als Open Source veröffentlicht eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. Programmieren (Python) kostenlos, Open Source

Synthetische Texte

Künstliche Texte erzeugen, z. B. Beispiel-Beratungsnotizen. Lasst sie nur aus Kategorien erzeugen (z. B. „Frau, 30–39, Schuldenberatung“), nie aus echten Texten, und prüft die Ergebnisse auf echte Details.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
Lokales Sprachmodell, z. B. mit Ollama Vorgehen Das Modell schreibt Beispieltexte aus codierten Kategorien (z. B. „Frau, 30–39, Schuldenberatung“). Gebt nie echte Texte ein und prüft die Ergebnisse auf echte Details auf Eurem Rechner etwas Einarbeitung kostenlos, Open Source
Kiln Programm Erzeugt viele Beispieltexte auf einmal aus einer Themenliste, z. B. aus Kombinationen von Kategorien. Nutzt es mit einem lokalen Sprachmodell (Ollama), auch wenn die Anleitung Cloud-Modelle empfiehlt. Schickt Nutzungsstatistiken an den Hersteller auf Eurem Rechner (mit lokalem Sprachmodell; sonst beim Cloud-Anbieter) etwas Einarbeitung kostenlos; Quellcode einsehbar, nicht Open Source

Schwärzung

Namen, Adressen usw. mit einem Tool ersetzen, danach jedes Dokument selbst prüfen.

ToolArtKurzbeschreibungVerarbeitungsortVorkenntnisseKosten
NameScrub Webseite Für deutsche Texte gemacht. Arbeitet ohne KI, mit Wortlisten und Regeln. Ersetzt Namen, E-Mails, Telefonnummern und IBANs durch nummerierte Platzhalter im Browser keine kostenlos, Open Source
Textshield Webseite Webseite aus der Schweiz, erkennt Namen usw. mit einem mehrsprachigen KI-Modell. Gratisversion bis 16.000 Zeichen im Browser keine Gratisversion + Bezahlversion
DFKI Privacy Guardrail Browser-Erweiterung (Chrome) Ersetzt Namen usw. direkt beim Eingeben in KI-Chats im Browser keine kostenlos, Open Source
Presidio Python-Paket Weit verbreitet, z. B. im Caritas-ChatbotChatbotEin Chatbot ist eine Software, die textbasierte oder gesprochene Kommunikation über ein Eingabe- und Ausgabefeld ermöglicht.. Es handelt sich um ein Teilgebiet der Künstlichen Intelligenz, in dem Methoden entwickelt werden, um automatisierte Dialogsysteme zu erstellen. Im öffentlichen Diskurs steht der Begriff meist für Anwendungen in Kommunikationskanälen wie Webseiten und sozialen Medien, um Kundensupport zu bieten und Anfragen zu beantworten. Ein Beispiel ist die Möglichkeit der Stornierung von Online-Bestellungen über einen Chatbot.. Stammt von Microsoft, heute pflegt es eine Community. Rahmen für eigene Regeln und Erkennungsmodelle; wie viel es findet, hängt vom gewählten Modell ab eigener Rechner oder ServerServerServer-Client-Modell Server und Client sind zwei zentrale Konzepte in der IT, die das Verhältnis zwischen zwei Systemen beschreiben: Der Client ist das Gerät oder das Programm, das eine Anfrage stellt (z. B. ein Webbrowser). Der Server ist das Gerät oder das Programm, das die Anfrage bearbeitet und dem Client die gewünschten Daten oder Dienste bereitstellt (z. B. ein Webserver-Programm). Diese Kommunikation findet in vielen digitalen Anwendungen statt, von Websites bis zu Cloud-Diensten. Ihr könnt euch einen Server wie eine zentrale Telefonauskunft vorstellen: Sie hat Zugriff auf Informationen und ist dafür da, Anfragen zu beantworten. Die Clients sind wie die Menschen, die bei der Auskunft anrufen: Sie stellen eine konkrete Anfrage und bekommen eine Antwort. Die Auskunftszentrale kann dabei parallel mehrere Anrufe entgegennehmen und Informationen bereitstellen. Server als Rechner Was manchmal zu Verwirrung führen kann: der Begriff “Server” bezeichnet sowohl den Rechner als auch die Server-Programme, die auf ihm laufen. So könntet ihr auf einem Server (Rechner) euren Webserver (Programm), E-Mail Server (Programm) und einen API-Server (Programm) betreiben. Programmieren (Python) kostenlos, Open Source
Lokales Sprachmodell, z. B. mit Ollama Vorgehen Ihr promptet ein Sprachmodell auf Eurem Rechner, Namen, Adressen usw. durch Platzhalter zu ersetzen. Es findet nicht alles und kann den Text unbemerkt verändern, vergleicht ihn deshalb mit dem Original. Nur lokal nutzen. Gebt Ihr dasselbe in ChatGPTChatGPTChatGPT ist ein Chatbot, der von der Firma OpenAI entwickelt wurde. ChatGPT ahmt Unterhaltungen von Menschen nach. Im Hintergrund wird dafür ein KI Sprachmodell, ein sogenanntes Large Language Model (LLM) verwendet. Die Veröffentlichung von ChatGPT im Jahr 2022 hat große Wellen in der breiten Öffentlichkeit geschlagen und LLMs schlagartig populär gemacht. ChatGPT kann mit unterschiedlichen LLMs als Grundlage ausgeführt werden. & Co. ein, übermittelt Ihr die Daten (s. Grundwissen Datenschutz) auf Eurem Rechner etwas Einarbeitung kostenlos, Open Source

Ihr könnt einen Text dauerhaft schwärzen, um ihn zu teilen. Oder Ihr ersetzt Namen usw. umkehrbar, bevor Ihr den Text in ein KI-Tool gebt. Umkehrbar ersetzte Texte bleiben personenbezogen. Mit dem Anbieter des KI-Tools braucht Ihr deshalb trotzdem einen AVV (s. Grundwissen Datenschutz).